ProCat Solutions
Mit tud ma egy otthon futó AI, az RTX-es géptől a feltört PS5-ig
Egy feltört PS5 húsz tokent ír másodpercenként, egy könyvméretű mini PC 235 milliárdos modellt futtat. Mennyibe kerül a saját AI-gép, mennyit fogyaszt, és mikor jobb a felhő?
Egy feltört PlayStation 5 másodpercenként nagyjából húsz tokent, durván tizenöt szót ír egy 27 milliárd paraméteres nyelvi modellel. Ugyanez a modell a konzol processzorán percenként egyet. A két szám közti szakadék elmagyarázza, miért a memória a legfontosabb alkatrész, ha valaki saját gépen akar mesterséges intelligenciát futtatni.
A PS5-ös kísérlet hobbi, jailbreak nélkül nem is működik. A változás, amelyet mutat, viszont valós. A nyílt modellek, a Qwen, a DeepSeek vagy az OpenAI gpt-oss családja ma már elég jók ahhoz, hogy egy cég kódot írasson, szerződést foglaltasson össze vagy a saját dokumentumai között kerestessen velük, úgy, hogy egyetlen sor sem kerül ki a szerverszobából. A nyitott kérdés az, mennyibe kerül a vas, és mennyit fogyaszt.
A memória dönt
Egy nyelvi modell minden egyes szó előállításakor végigolvassa a saját súlyait. Ha ezek nem férnek be a videokártya memóriájába, a gép a lassú rendszermemóriához nyúl, és a sebesség a töredékére esik. A tempót ezért elsősorban a memória mérete és sávszélessége szabja meg.
Két trükk segít. A kvantálás 16 bitről 4 bitre tömöríti a súlyokat, így egy 32 milliárd paraméteres modell nagyjából 20 gigabájtba belefér, érezhető minőségromlás nélkül. A mixture-of-experts (MoE) modellekben minden szónál a hálózatnak csak egy része dolgozik, egy 30 milliárdos modellből 3 milliárd, ezért ezek jóval gyorsabbak, mint a méretük alapján várnánk. A sebességet token/másodpercben mérik; 15–20 körül a szöveg nagyjából olvasási tempóban jelenik meg.
A klasszikus út: egy erős videokártya
A legegyszerűbb megoldás egy játékra tervezett csúcskártya. A hardware-corner.net mérései szerint az RTX 5090 a Qwen3 32B modellt 4 bites tömörítéssel 44–61 token/s-mal futtatja, a MoE felépítésű Qwen3-Coder-30B-A3B-t 240 fölött. Ezt olvasva már senki nem tudja követni.
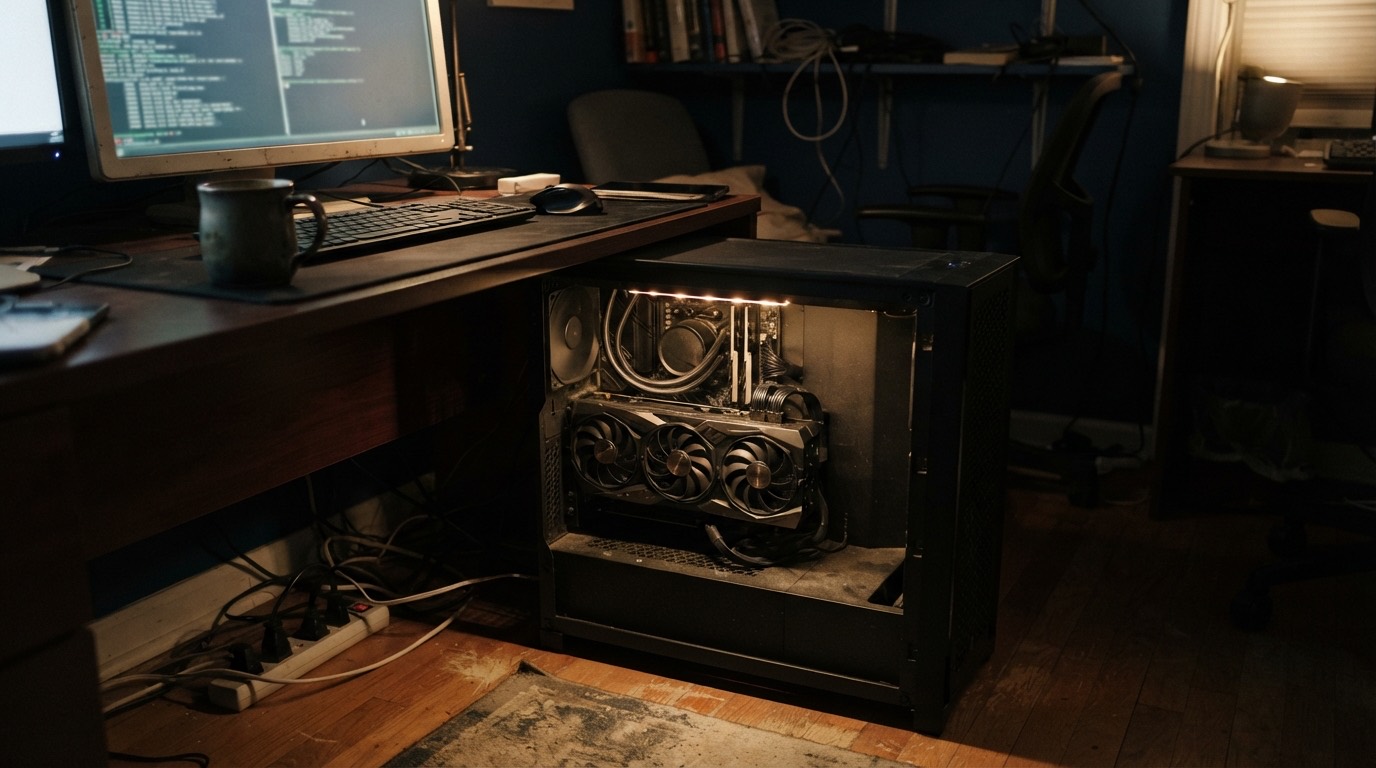
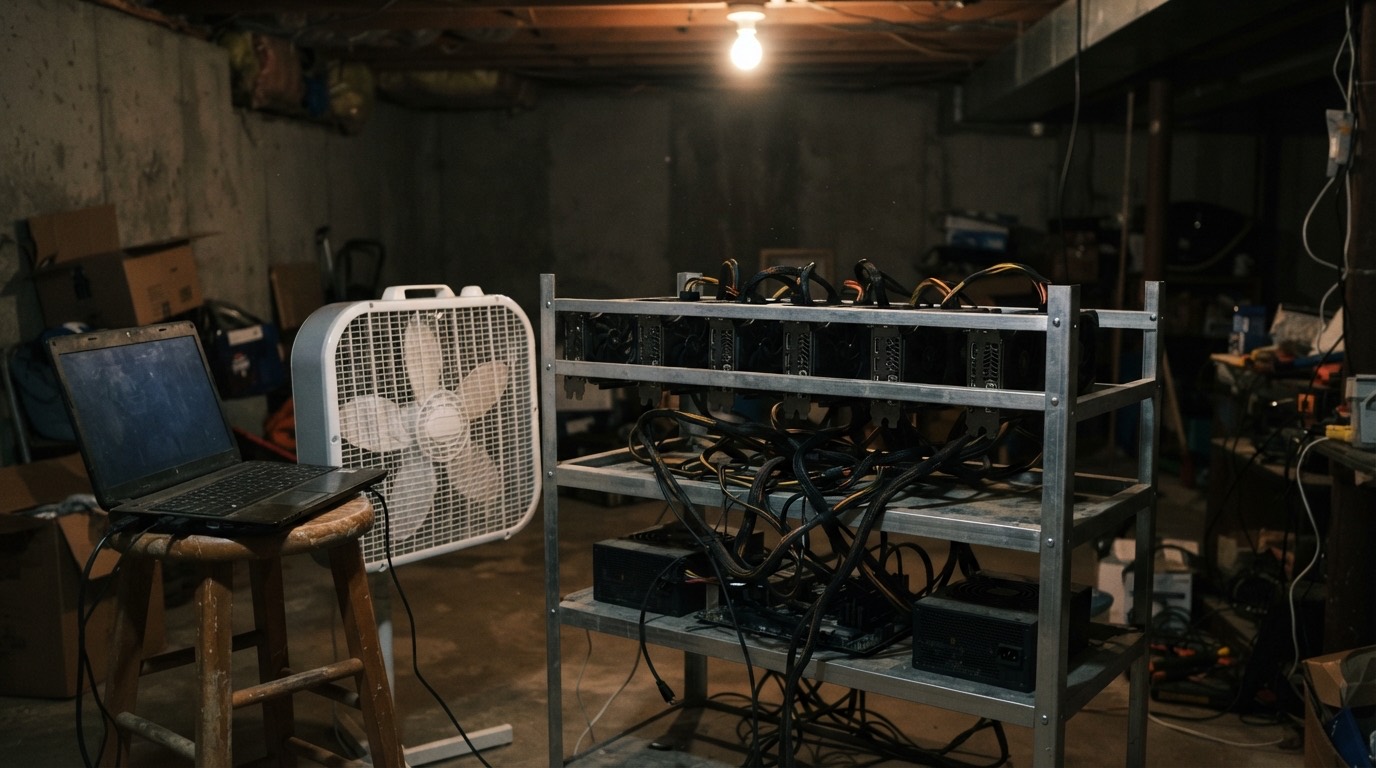
Aki spórolna, használt RTX 3090-et vesz. A 2020-as kártyán 24 GB memória van, egy 32 milliárdos modellel kb. 37 token/s-ot tud, kettővel egy 70 milliárdos modell is elfut 15–20 token/s körül. A különbözetet az áramszolgáltató hajtja be: egy 3090 egymagában 350 wattot vesz fel, a teljes gép terhelés alatt 850 körül jár, és nyáron ezt a szoba hőmérsékletén is látni.
Könyvméretű gépek, kétszáz watt alatt
Az elmúlt év meglepetése a mini PC-ké. Az AMD Ryzen AI Max+ 395 („Strix Halo”) processzorral szerelt dobozokban 128 GB közös memória van, amelyből a beépített grafikus egység is bőven meríthet. A mérések szerint egy ilyen gép a Qwen3-30B-A3B-t nagyjából 100, a hatalmas Qwen3-235B-t 11 token/s-mal futtatja, közben a konnektornál 120–140 wattot fogyaszt. A 128 GB-os GMKtec EVO-X2 ára a memóriaárak emelkedése óta 2000–2300 dollár körül mozog.
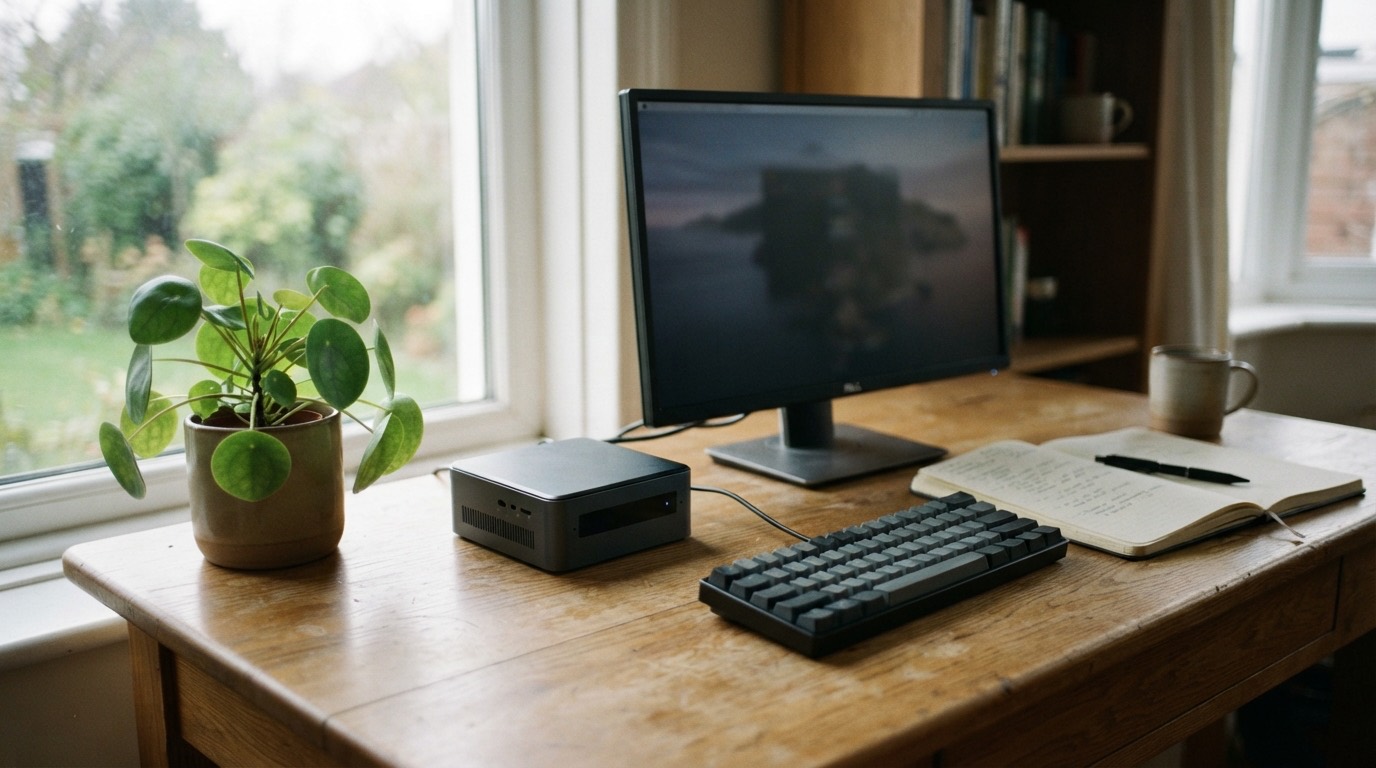
Ugyanebben a súlycsoportban versenyez az NVIDIA asztali DGX Sparkja (128 GB, 4699 dollár), amely a gpt-oss-120b-t 38–55 token/s-mal hajtja, és az Apple Mac Studio. Az M3 Ultra csippel és 512 GB memóriával szerelt változat a teljes, 671 milliárd paraméteres DeepSeek R1-et is betölti 4 biten, és 17–18 token/s-mal futtatja, a TechRadar mérése szerint 200 wattnál kevesebből.
A skála furcsa vége
A PS5 nem az egyetlen gép, amelyet nem erre terveztek.
- PlayStation 5. A PS5LM nevű projekt a népszerű llama.cpp-t portolta a feltört konzolra. A gépben 16 GB GDDR6 memória van 448 GB/s sávszélességgel, ami papíron sok irodai videokártyát lepipál. A kisebb modellek 100 token/s fölött futnak rajta.
- Mac Studio-klaszter. Az exo nevű szoftver több Macet egyetlen nagy gépként kezel. Mióta a macOS 26.2 Thunderbolt 5-ön keresztül RDMA-t is tud, négy Mac Studio együtt 32 token/s-mal futtatja a Qwen3 235B-t. Jeff Geerling így rakott össze 1,5 terabájt közös memóriát, nagyjából 40 ezer dollárért.
- Raspberry Pi 5. A bankkártya méretű gépen egy egymilliárd paraméteres Llama 3.2 11–20, egy hárommilliárdos Qwen 5 token/s körül fut. Okosotthonba, egyszerű feladatokra elég.
- Windows 98. Az EXO Labs egy eBay-en vett, 1997-es Pentium II-es gépen, 128 MB memóriával futtatott nyelvi modellt. Egy 260 ezer paraméteres apróság 39 token/s-mal ment, a Llama 3.2 1B 0,0093-mal: egyetlen tokenre 107 másodpercet kellett várni.
Számokban
| Gép | Memória | Mért példa | Fogyasztás | Ár (kb.) |
|---|---|---|---|---|
| RTX 5090 asztali gép | 32 GB | Qwen3 32B: 44-61 tok/s | nagy (több száz W) | csak a kártya ~2000 $+ |
| 2× RTX 3090 (használt) | 2×24 GB | 70B modell: 15-20 tok/s | ~350 W kártyánként | használt piac |
| Ryzen AI Max+ 395 mini PC | 128 GB közös | Qwen3-235B: ~11 tok/s | 120-140 W | 2000-2300 $ |
| NVIDIA DGX Spark | 128 GB közös | gpt-oss-120b: 38-55 tok/s | kicsi | 4699 $ |
| Mac Studio M3 Ultra | 512 GB közös | DeepSeek R1 671B: 17-18 tok/s | <200 W | prémium |
| Feltört PS5 | 16 GB GDDR6 | Qwen 27B: ~20 tok/s | konzol | konzol + jailbreak |
| Raspberry Pi 5 | 8-16 GB | Llama 3.2 1B: 11-20 tok/s | néhány W | olcsó |
A számok különböző mérésekből, eltérő beállításokkal készültek. Nagyságrendet mutatnak, nem bajnoki tabellát.
Mire használják
- Programozás. A Qwen3-Coder és társai helyben javasolnak kódot, magyarázzák a régit, tesztet írnak hozzá. A forráskód közben nem hagyja el a céget, ami sok ügyfélszerződésben eleve feltétel.
- Szöveg. Vázlat, összefoglaló, fordítás, e-mail. Szerződéseknél és belső anyagoknál a fő érv, hogy semmi nem kerül harmadik félhez.
- Hang és kép. Felvételek leiratozása, videók feliratozása és képgenerálás, ugyanazon a vason.
- Céges tudásbázis. Asszisztens, amely a cég saját dokumentumaiból válaszol. Erről az Abisearch kapcsán írtunk bővebben.
Saját gép vagy felhő?
| Szempont | Helyi gép | Felhő (API vagy bérelt GPU) |
|---|---|---|
| Indulás | egyszeri hardverköltség | nincs, azonnal indul |
| Folyamatos költség | áram, karbantartás | használat szerint, nagy forgalomnál drága |
| Adatvédelem | az adat nem hagyja el a gépet | szolgáltatótól és szerződéstől függ |
| Legjobb modellek | csak nyílt modellek | a legerősebb zárt modellek is |
| Skálázás | annyi, amennyi a gép | gyakorlatilag korlátlan |
| Offline működés | igen | nem |
| Üzemeltetés | a mi dolgunk | a szolgáltatóé |
Aki nem akar gépet venni, bérelhet: egy H100-as szerver-GPU 2026-ban óránként nagyjából 2–4 dollár, a Lambda és a RunPod ebben a sávban áraz. Egyenletes, napi használatnál a saját gép hamar megtérül, alkalmi csúcsokra a bérlés vagy egy felhős API olcsóbb.
Hol kezdjük
Cégeknél ritkán a gépvásárlás az első lépés. Előbb azt kell tisztázni, mire használnák, mekkora modell elég hozzá, és hányan dolgoznak vele egyszerre. Ebből derül ki, hogy elég egy mini PC az iroda sarkában, kell egy RTX-es szerver, vagy jobban jár a cég, ha a nyílt modell felhőben fut. Ilyen rendszereket építünk: saját szerverre telepített modellt és a hozzá tartozó belső felületet is.
Források
- PS5LM a GitHubon és a Tom’s Hardware cikke
- Mac Studio M3 Ultra és DeepSeek R1 (MacRumors), fogyasztás (TechRadar)
- RTX 5090 LLM mérések (hardware-corner.net)
- RTX 3090 helyi LLM-hez (llmhardware.io)
- Strix Halo mérések (GitHub), fogyasztás (TechPowerUp), GMKtec EVO-X2 (Tom’s Hardware)
- DGX Spark mérések (Spheron)
- Mac Studio klaszter RDMA-val (Jeff Geerling), AppleInsider
- Llama Windows 98-on (Hackaday)
- Raspberry Pi 5 mérések
- H100 bérlési árak (Spheron, Lambda), RunPod